چند هفته پیش که در بستر آنفولانزا (شبهکرونا) خانهنشین شده بودم، استاد بزرگوار شیخ خدادادنژاد عزیز تماس گرفتند و پرسیدند که برای تحلیل یک فایل بزرگ نیاز به مدل هوش مصنوعی بدون محدودیت دارند (پیشتر درباره مدلهای آفلاین از من شنیده بودند)، که متوجه شدم میخواهند اکسپورت گروه تلگرامی دانشگاه را برای پردازش و بررسی دیدگاه دانشجویان درباره هر استاد به هوش مصنوعی بدهند، فشار خانهنشینی و هجر کیبورد از یک سو و ذوق چالش از سوی دیگر مرا بر آن داشت که سری که درد میکند را دستمال ببندم و با همراهی qwen دوست داشتنی، پای پروژه استادسنج1 که در ابتدا یه اسکریپت ساده بود بنشینم.
با کمی تحقیق و تست اولیه و مزهمزه کردن (در قالب اسکریپتی کوچک) با دادههای محدود و مدلی لوکال به این نتیجه رسیدم که میشود نظرات را پردازش و کارنامهای نهایی برای هر استاد تولید کرد، پس از همان ابتدا تصمیم گرفتم پروژه را در قالب پروژهای تحت وب پیش ببرم.
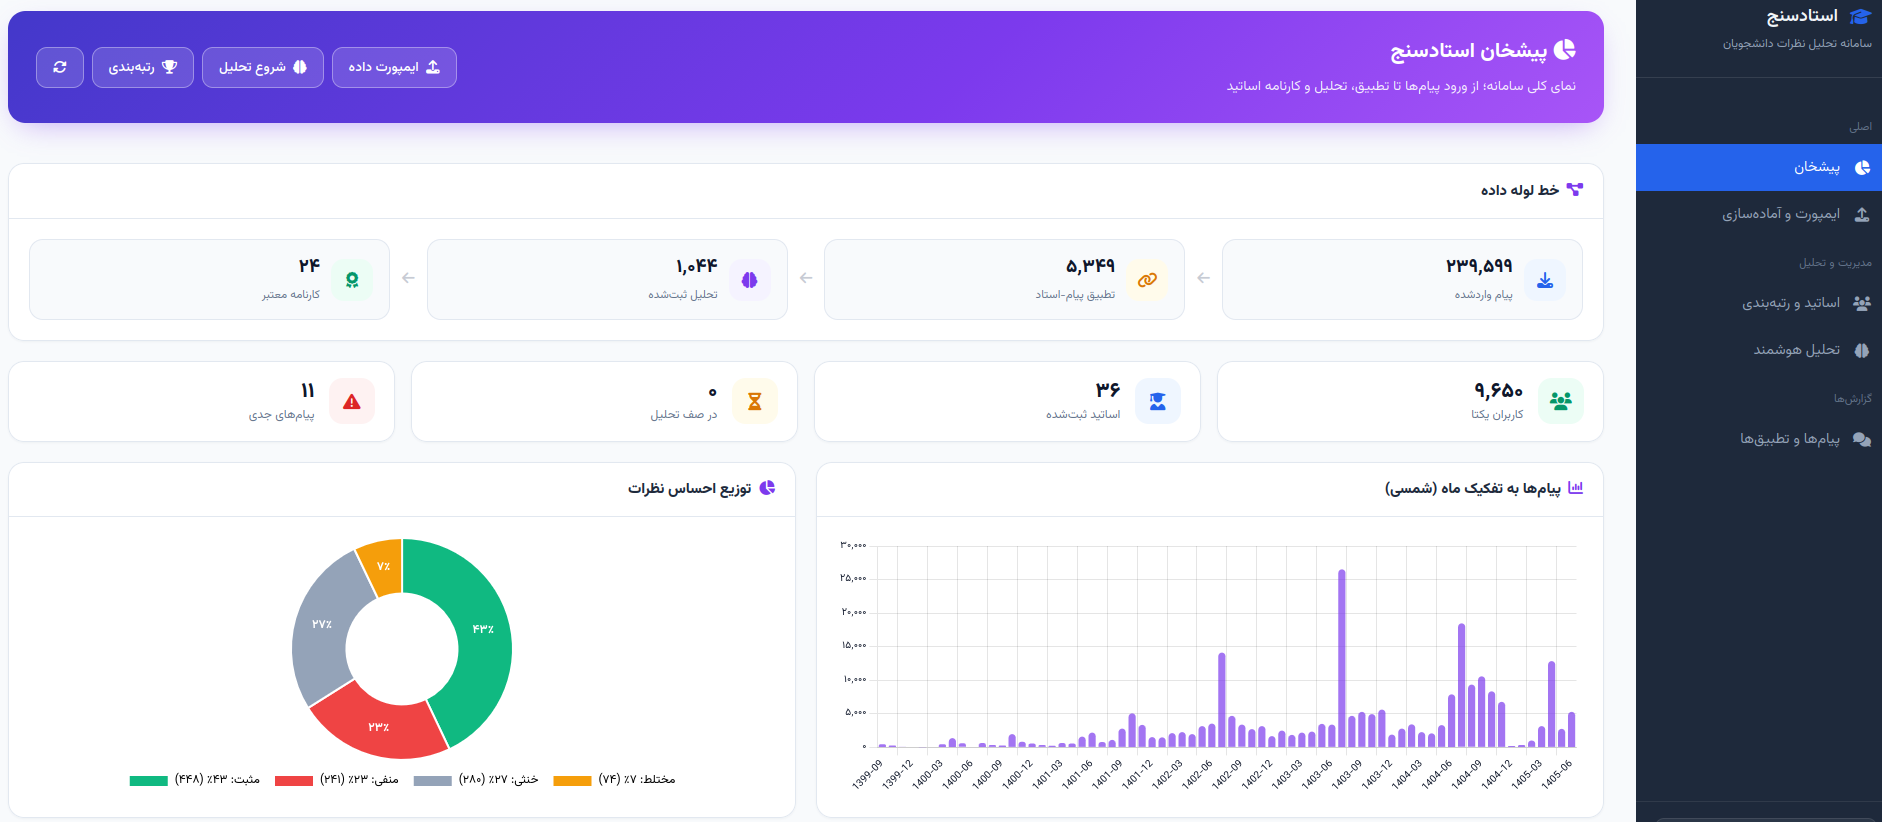
همانطور که از تماس اولیه برمیآمد چالش اولیه این مسیر حجم بزرگ داده ورودی بود، در نگاه اول با یک گروه تلگرامی با چیزی نزدیک به ده هزار کاربر و ۲۵۰ هزار پیام گوناگون در بازه ۵ ساله مواجه بودم!
⚠️ گروه مورد بررسی گروهی پابلیک در تلگرام است ولی برای حفظ حریم خصوصی در این گزارش دادهها تا جای ممکن فیلتر شدهاند.
به مدد تلگرام دسکتاپ از پیامهای متنی کاربران خروجی جیسون ۶ میلیون خطی گرفتم که با کمک پارسری ساده متن پیام، آیدی، آیدیِ پیام رپلای شده، هش آیدی کاربر (پرایوسی فرست 😎) و ریاکشنها را در دیتابیس SQLite ذخیره کردم (در این مرحله بر اساس حجم داده دیتابیس دیگر زیادهروی است)، در نسخههای اولیه ریاکشنها و رپلایها ذخیره نمیشدند ولی در بررسی خروجی نهایی تحلیل متوجه شدم که بخشی از نظرات در قالب همین زنجیره رپلای و واکنشهاست که در نسخه نهایی بکار گرفته شدند. (telegram_parser.py)
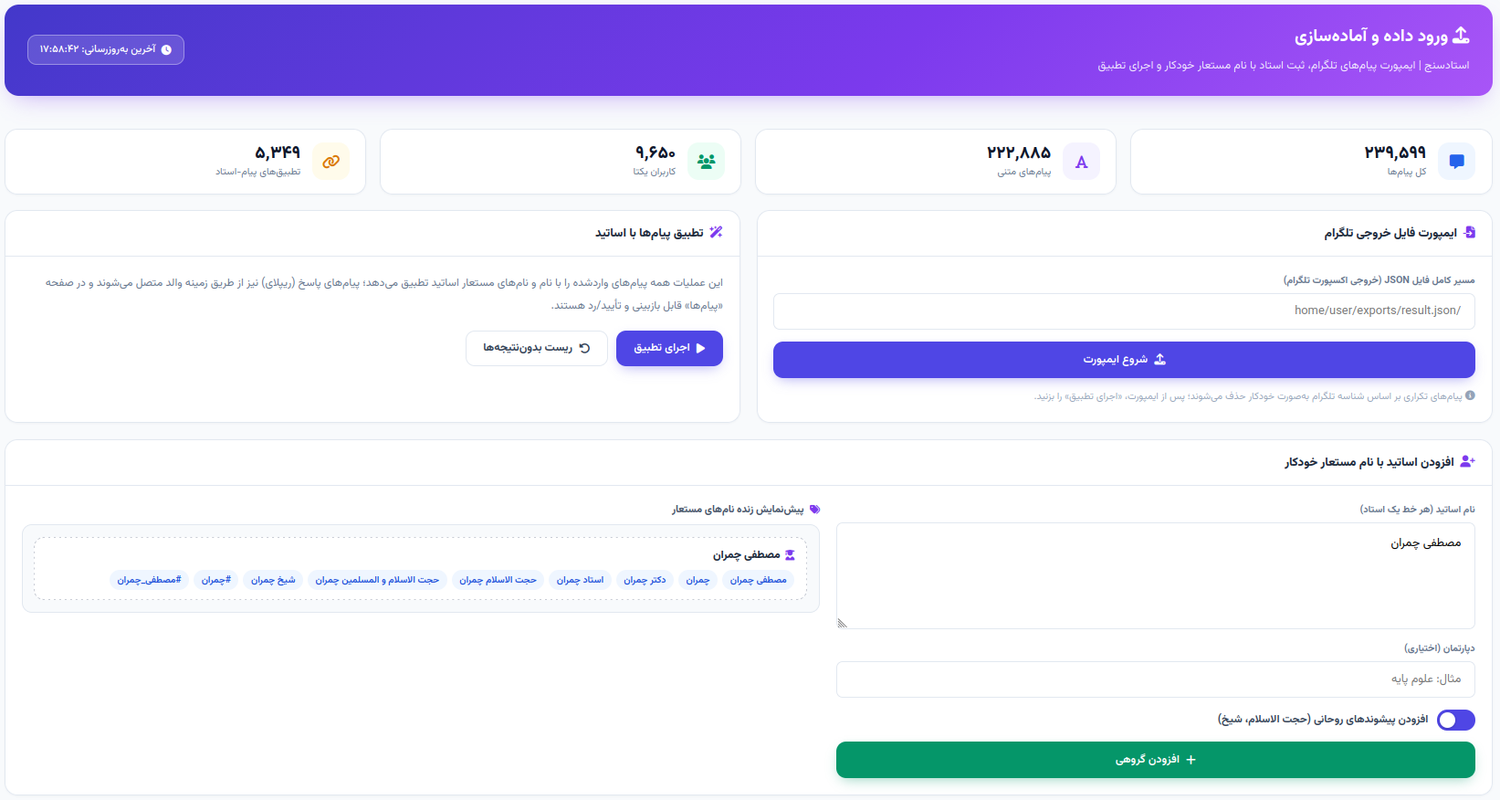
هسته اصلی جداسازی پیامهای نامزد بررسی، مبتنی بر بهکارگیری کلیدواژهها نوشته شده است و با توجه به گوناگونی شیوه نوشتار نام اساتید در پیامها از یک سیستم نام مستعار (Alias) خودکار در کنار نام اصلی استاد متشکل از ترکیبهای مختلف نام و نام خانوادگی و عناوین نیز استفاده کردم که پس از نرمالایز و پاکسازی اولیه، پیامهای شامل همین مجموعه اسامی یک استاد و زنجیره رپلایها به همراه واکنشها جداسازی میشوند، از بین ۲۵۰ هزار پیام گروه نمونه حدودا ۵ هزار پیام در الک ما باقی ماندند. (professor_matcher.py)
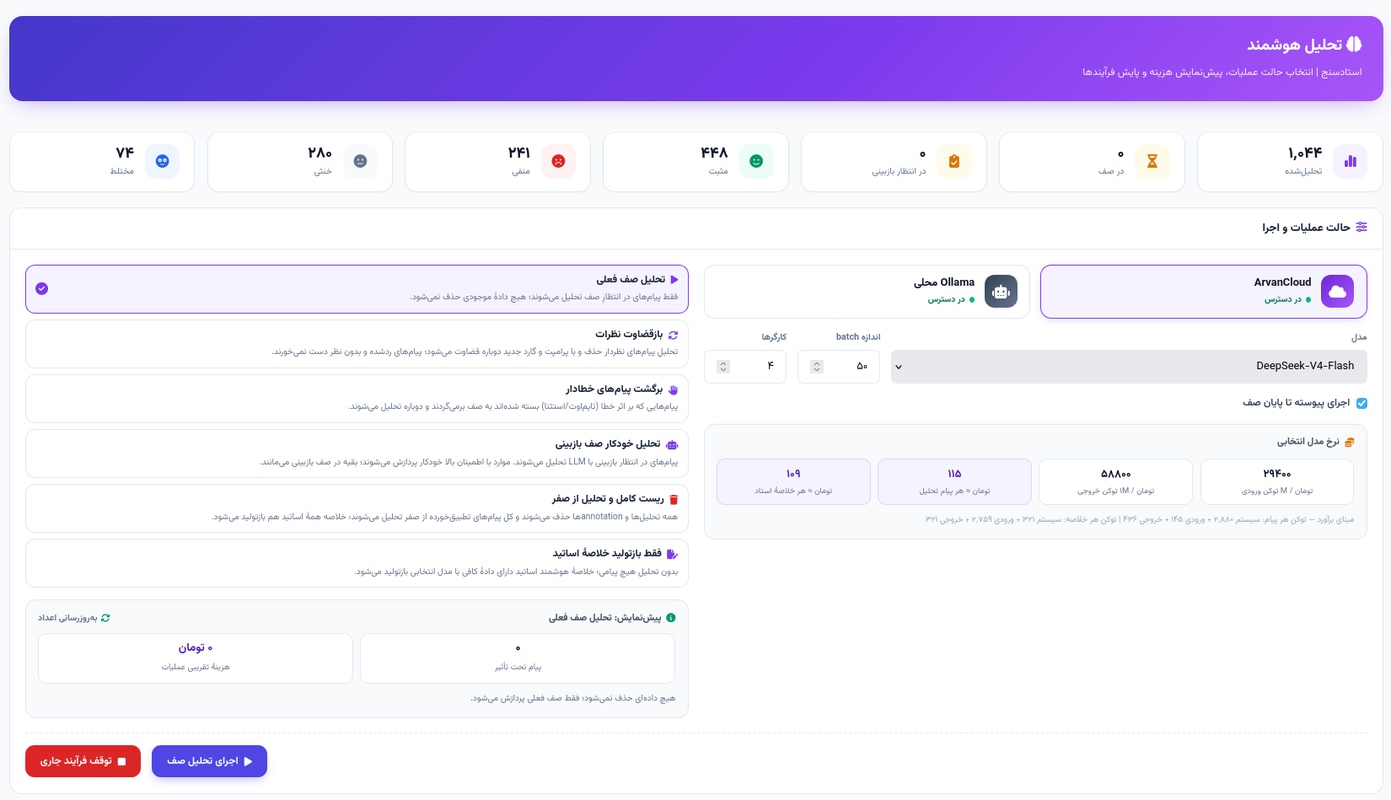
تستهای اولیه تحلیل را به کمک ollama و مدل gemma4:e4b-it-qat2 به شکل لوکال انجام دادم ولی به امید سرعت بیشتر چند ارائهدهنده آنلاین دیگر (رایگان و پولی) را تست کردم تا بر روی AIaaS ابرآروان با مدل DeepSeek-V4-Flash مواجه شدم، که در مقابل سرعت و کیفیت مورد نیاز پروژه من مُفت بود!
در هسته تحلیل، در گام پایهای هر پیام به همراه یک ابرپرامپت به LLM داده میشود تا مدل به ازای هر پیام یک تحلیل در ساختار جیسون مشخص شامل این موارد برگرداند:
ارتباط پیام (is_relevant): یک متغیر منطقی که مشخص میکند پیام اصلاً به این استاد و درس او مربوط است یا خیر.
نوع پیام (message_type): دستهبندی ماهیت پیام (مثل ارزیابی، شکایت، پیشنهاد یا سوال).
شامل نظر بودن (contains_opinion): مشخص میکند آیا پیام شامل تجربه و ارزیابی واقعی است یا صرفاً یک خبر، سوال یا برچسب ساده است.
نوع حس (sentiment): تعیین جهتگیری کلی پیام از میان ۴ حالت: positive (مثبت)، negative (منفی)، neutral (خنثی)، یا mixed (مختلط).
امتیاز عددی حس (sentiment_score): یک عدد اعشاری دقیق بین ۱.۰- تا ۱.۰+ برای سنجش شدت مثبت یا منفی بودن نظر.
ابعاد عملکردی (aspects): لیستی از ابعاد مشخص (مثل کیفیت تدریس، نمرهدهی، اخلاق، حضور و غیاب، جزوه و…) همراه با امتیاز آن.
موضوعات استاندارد (topics): لیستی از کلیدواژهها و موضوعات پرتکرار انتخابشده از یک فهرست استاندارد.
خلاصه نظر (key_point): یک جمله کوتاه و فشرده به زبان فارسی که عصاره نظر دانشجو را بدون ذکر نام استاد بیان میکند.
درجه حساسیت (severity): تعیین میزان جدی بودن پیام از میان none، low، medium یا high (برای موارد خاص مثل اتهام تبعیض، توهین یا تخلف).
میزان اطمینان مدل (confidence): عددی بین ۰ تا ۱ که نشان میدهد خودِ مدل چقدر از صحت این تحلیل و ارزیابی مطمئن است.
در این بخش با مهندسی پرامپت تلاش کردم خطاهای سیستم در تشخیص اشتباه نام اساتید یا درسها را کنترل کنم. پس از پایان این مرحله که توکنخوارترین و کندترین قسمت فرآیند بود، پیامهای مشکوک (با میزان اطمینان کم مدل یا پیامهایی که در زنجیره رپلای هستند) برای بازبینی تگگذاری میشوند که در مرحله اول با مدل هوش مصنوعی و باقیماندهها در مرحله دوم توسط کاربر باید تطبیق داده شوند.
در گام نهایی پس از تحلیل اولیه، خلاصه نظرات، موضوعات و امتیازهای هر استاد در قالب یک ابرپرامپت دیگر به LLM داده میشود تا خلاصه کلی، نقاط ضعف و قوت هر استاد را برگرداند، این مرحله را میتوان با مدلی قویتر اجرا کرد.(prompts.py)
یک سابسیستم کوچک برای تخمین توکن مصرفی و هزینهها و بررسی و اجرای حالتهای مختلف پردازش نیز در این صفحه از پروژه گنجانده شده است.
پس از پایان پردازش، از دل آن پیامهای پراکنده پروفایلی تحلیلی و چشمنواز برای هر استاد متولد شد، که در کنار فهرست ردهبندی عادلانه اساتید مبتنی بر میانگین بیزی3، یک داشبورد دادهمحور هوشمند در اختیار کاربر قرار میدهد.
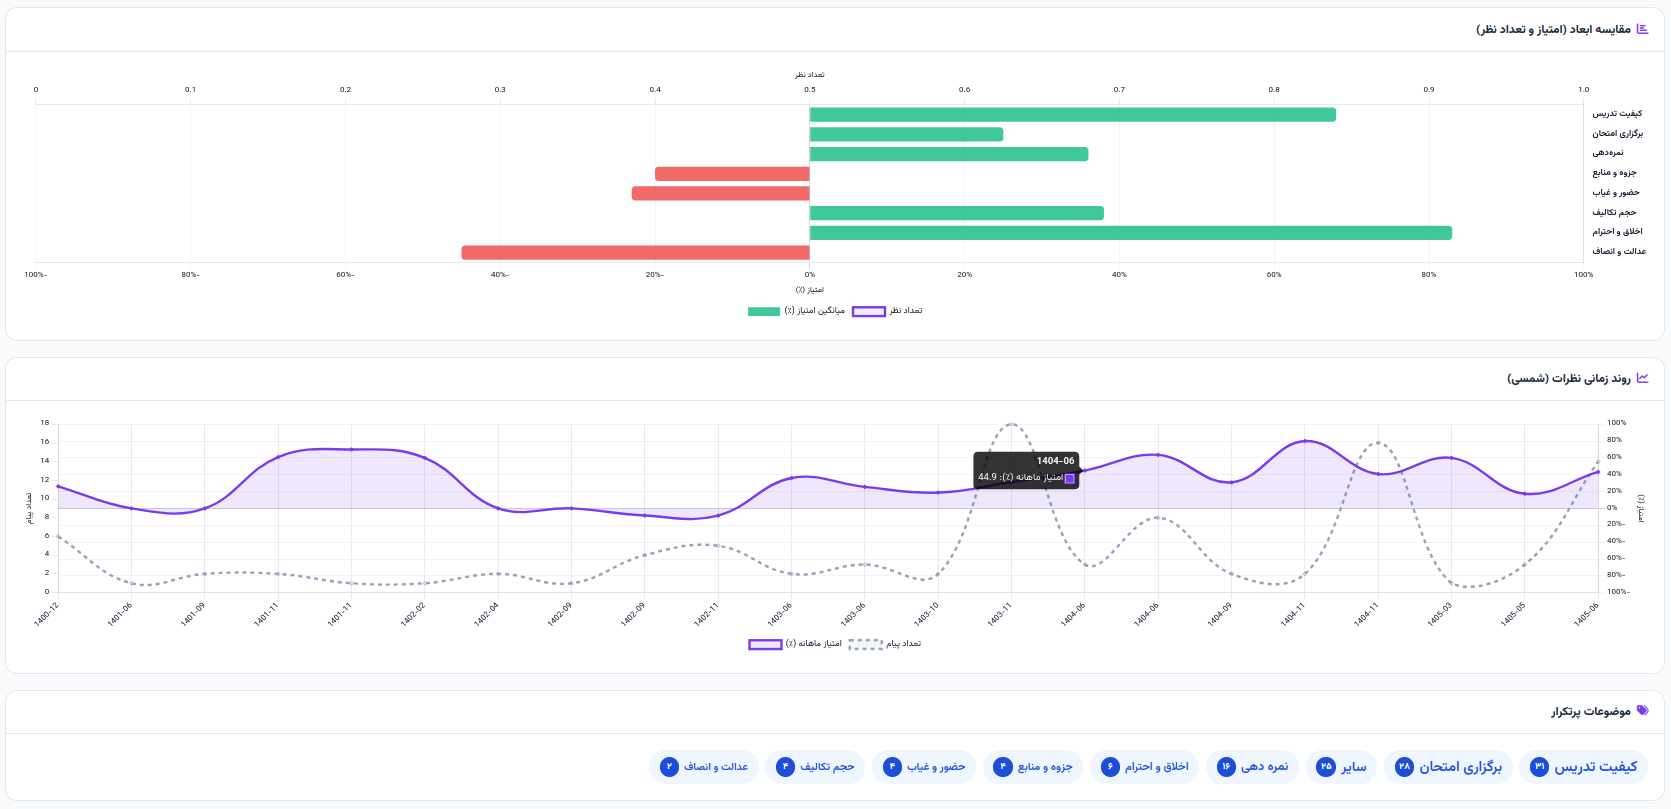
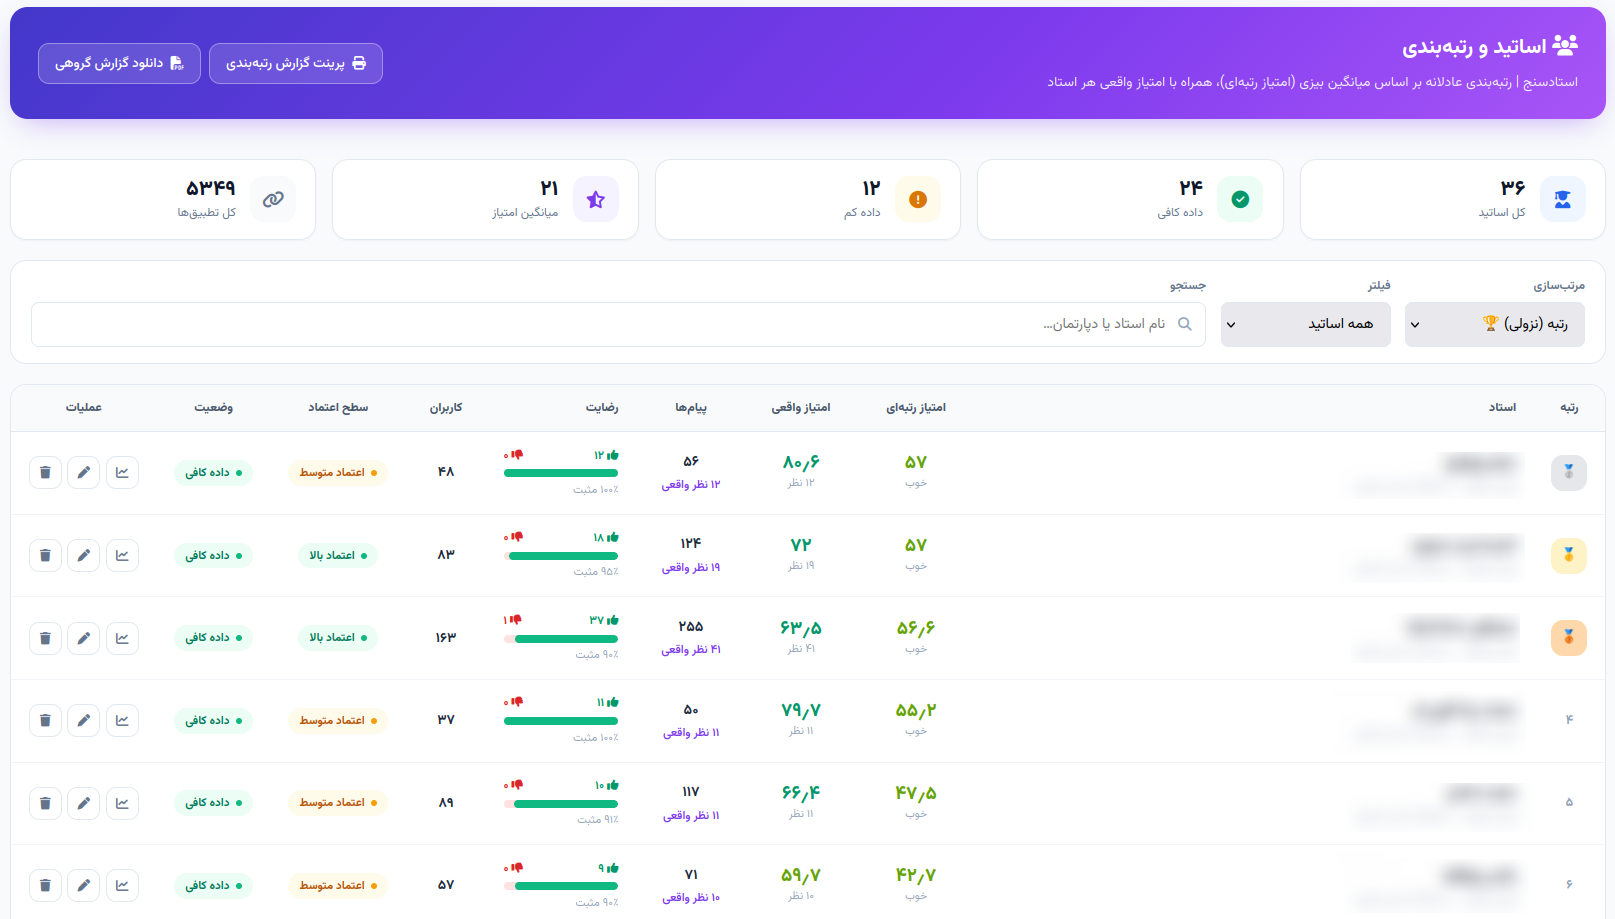
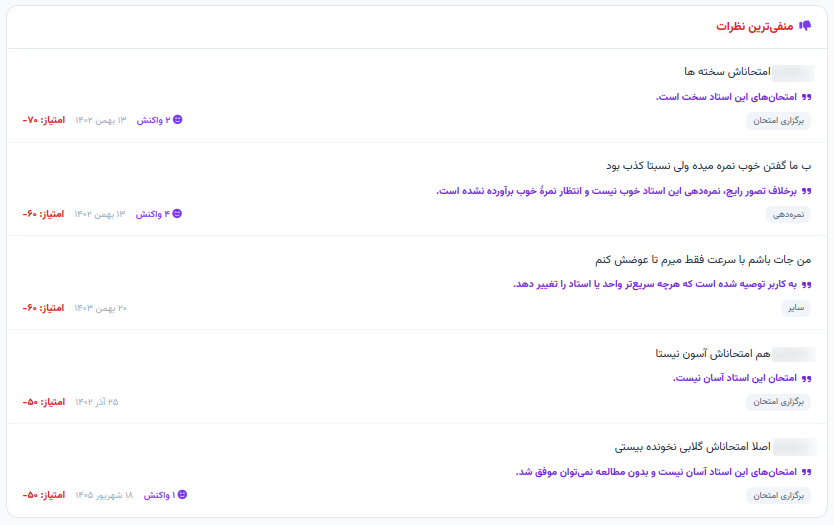
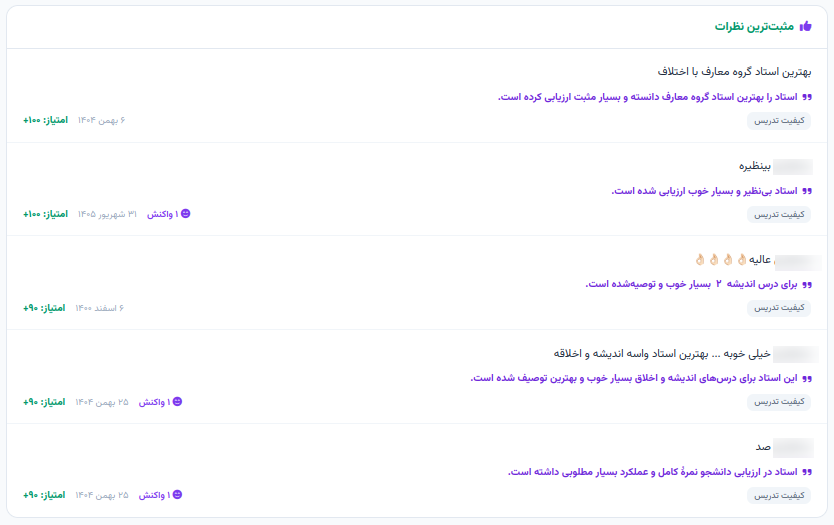
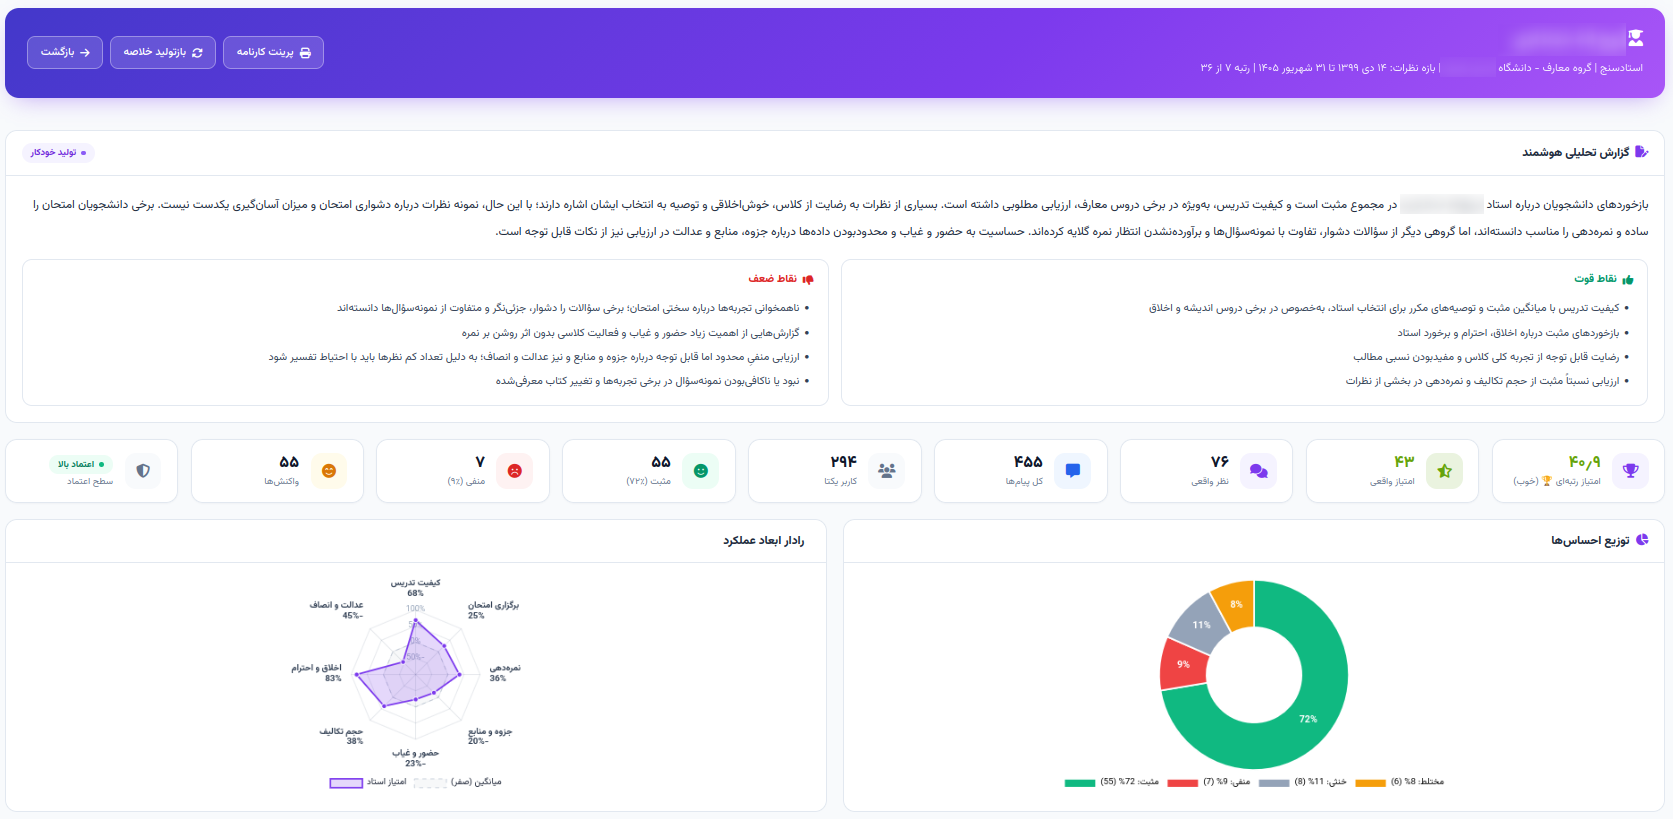
و شد آنچه باید میشد؛ خروجی نهایی پروژهای فان و چندروزه، هم در نظر استاد مکرم خوش افتاد و هم برای منِ تازه از بستر برخاسته، تجربه سازنده خوشایندی بود.

دیدگاهتان را بنویسید